

Селекция каннабиса всегда строилась на наблюдении и практике. Выбирались самые сильные растения, оценивалась структура куста, плотность и форма соцветий, скорость перехода к цветению. Проводился лабораторный анализ уровня ТГК и КБД, отслеживалась стабильность показателей от цикла к циклу. Затем отобранные экземпляры скрещивались, а потомство снова проходило проверку. Такой метод остается рабочим, потому что он опирается на реальные результаты выращивания и позволяет видеть поведение растения в конкретных условиях.
Со временем к этим этапам добавилось больше точных измерений. Помимо визуальной оценки и базового химического анализа появились генетические тесты, расширенные профили каннабиноидов и терпенов, детальная фиксация освещения, температуры, влажности и схемы питания. По каждой линии накапливаются данные о реакции на стресс, урожайности и воспроизводимости характеристик.
Когда селекционная программа включает десятки или сотни линий, объем информации становится значительным. Сопоставить все параметры вручную сложно, особенно если нужно учитывать сразу генетику, химический состав и условия выращивания.
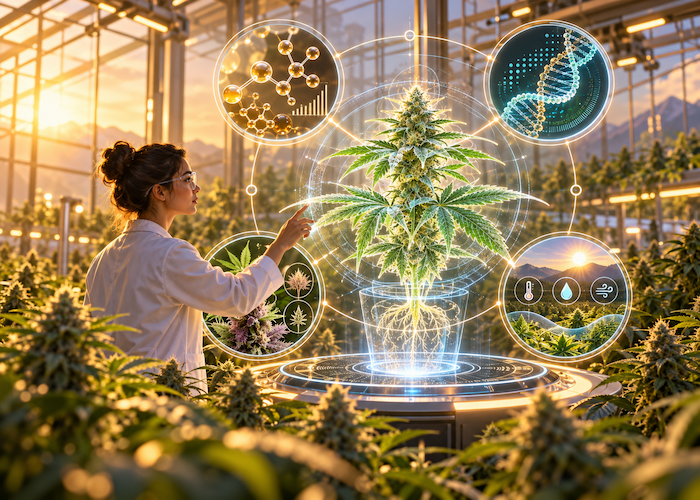
Именно здесь в работу включается машинное обучение. Это способ анализа больших массивов данных, который помогает выявлять устойчивые связи между генами, химическим профилем и средой. Он не заменяет опыт селекционера, но делает анализ более системным и позволяет принимать решения на основе количественной оценки.
Как генетика помогает предсказывать результат
В основе химического профиля каннабиса лежит работа конкретных генов, которые отвечают за синтез ферментов каннабиноидного пути. Эти ферменты участвуют в последовательных реакциях внутри клетки и определяют, какие соединения и в каком соотношении будут накапливаться в соцветиях. Если в генах есть различия — например, изменения в последовательности ДНК или в числе копий, — это может влиять на активность ферментов и, соответственно, на соотношение ТГК, КБД и других каннабиноидов.
Важно понимать, что химический профиль формируется не одним геном, а целой группой участков ДНК. Одни отвечают за сами синтазы, другие — за регуляцию их активности. Поэтому анализируется не отдельная мутация, а совокупность генетических особенностей растения.
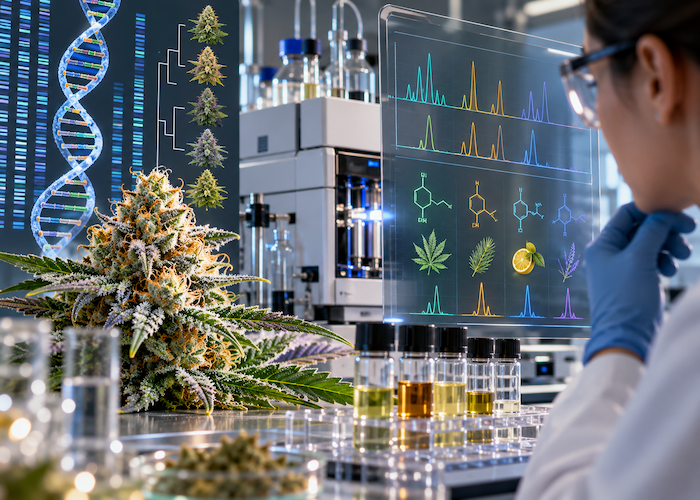
Современное секвенирование позволяет получить подробную информацию о генетических вариациях — от одиночных замен нуклеотидов до более крупных структурных изменений. Параллельно лаборатории измеряют точное содержание каннабиноидов с помощью хроматографических методов. В результате формируются две базы данных: генетическая и химическая.
Алгоритмы машинного обучения сопоставляют эти массивы. Они анализируют, какие генетические особенности чаще встречаются у растений с определенным уровнем ТГК, КБД или минорных соединений. На основе повторяющихся закономерностей строится модель, которая способна оценить вероятность нужного результата еще на ранней стадии развития растения, иногда уже на этапе рассады.
Это не означает стопроцентную гарантию. Биологические системы всегда остаются вариативными. Однако селекционер получает количественный ориентир. Он помогает быстрее отсеивать неподходящие экземпляры и сосредоточиться на линиях с высокой вероятностью нужного профиля, сокращая время и ресурсы.
Почему одних генов недостаточно
Каннабис отличается высокой чувствительностью к условиям выращивания. Освещение, его спектр и интенсивность, температура воздуха и субстрата, влажность, режим питания — все это может заметно изменить химический профиль даже при одинаковом генотипе. Два растения с одинаковым набором генов способны показать разные показатели в зависимости от среды.
Поэтому современные модели учитывают не только данные ДНК, но и параметры выращивания. В анализ включаются сведения о микроклимате, составе субстрата, режиме полива и схеме питания. Это позволяет отделить влияние наследственности от влияния условий и точнее оценить вклад каждого фактора.
Такой подход особенно важен при оценке устойчивости к стрессам. Если растение демонстрирует стабильность при перепадах температуры, повышенной влажности или изменении освещения, алгоритм учитывает эту информацию вместе с генетическими маркерами. В результате формируется более реалистичная картина потенциала линии — не только по химическому профилю, но и по способности сохранять характеристики в разных условиях.
Поиск редких химических профилей
С развитием лабораторных методов стало возможным обнаруживать минорные каннабиноиды, которые раньше не фиксировались из-за низкой концентрации. Современные хроматографические системы позволяют измерять даже очень небольшие количества соединений, что расширило представление о химическом разнообразии каннабиса. Некоторые из этих веществ встречаются крайне редко и могут быть связаны с особыми генетическими комбинациями или специфическими условиями выращивания.
В крупных селекционных коллекциях, где число образцов может исчисляться сотнями, поиск таких редких профилей вручную становится трудоемким. Даже если лаборатория предоставляет полный химический отчет, сопоставить его с генетическими данными по всем линиям сложно без цифровой обработки.
Машинное обучение помогает ранжировать линии по вероятности наличия нестандартных сочетаний признаков. Алгоритм анализирует отклонения от типичных профилей и выделяет образцы, которые статистически отличаются от основной массы. В расчет берутся генетические маркеры, вариации числа копий генов, особенности регуляции и результаты химического анализа.
После цифрового отбора выбранные растения проверяются в лаборатории повторно. Это необходимо для подтверждения стабильности показателей и исключения случайных отклонений, связанных с условиями выращивания или техническими особенностями анализа. Таким образом формируется более точный список перспективных линий для дальнейшей работы.
Планирование скрещиваний
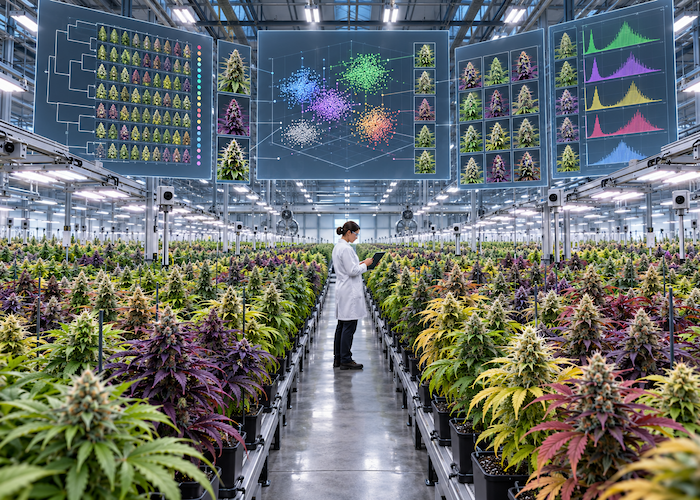
Алгоритмы используются и при выборе родительских пар, особенно в программах, где одновременно ведется работа с большим числом линий. Селекционер может проанализировать генетическую дистанцию между растениями, оценить степень их родства и понять, какие аллели с высокой вероятностью будут сочетаться в потомстве. Это снижает риск нежелательного накопления сходных участков генома и помогает поддерживать генетическое разнообразие.
В расчет включаются известные связи между генетическими вариантами и фенотипическими признаками. Учитывается химический профиль, сроки цветения, структура кроны, устойчивость к стрессам и стабильность показателей в разных условиях. Если определенные маркеры ассоциированы с нужным уровнем каннабиноидов или устойчивостью к влажности, модель оценивает вероятность их передачи потомству при конкретной комбинации родителей.
Модель не дает точного прогноза по каждому отдельному растению, поскольку наследование количественных признаков остается вероятностным процессом и зависит от распределения аллелей. Однако она показывает диапазон возможных результатов и вероятность появления желаемых характеристик в первом поколении и последующих циклах отбора.
Это помогает сократить число случайных комбинаций и уменьшить объем тестируемых скрещиваний. Селекционная программа планируется с учетом расчетных сценариев, что позволяет более рационально распределять пространство, время и лабораторные ресурсы. В результате повышается управляемость процесса и ускоряется достижение поставленных селекционных целей.
Что важно для точной работы
Для корректных прогнозов необходимы качественные и сопоставимые данные. Протоколы секвенирования должны быть стандартизированы: важны глубина покрытия, методы фильтрации генетических вариантов и единый формат хранения информации. Аналогичные требования предъявляются к химическому анализу. Методика экстракции, калибровка оборудования и повторяемость измерений напрямую влияют на итоговые значения концентраций каннабиноидов. Если лаборатории используют разные подходы, модель может учитывать технические различия как биологические.
Подробная фиксация условий выращивания имеет такое же значение, как и генетические тесты. Температура, влажность, интенсивность и спектр света, состав субстрата, режим полива и питания должны быть задокументированы. Это позволяет учитывать влияние среды и снижает риск ошибочных выводов о роли наследственности.
Каннабис только начинает формировать крупные генетические базы данных, сопоставимые по масштабу с базами по другим сельскохозяйственным культурам. По мере их расширения модели становятся устойчивее, поскольку обучаются на более разнообразных и репрезентативных выборках. Однако важно помнить, что алгоритмы выявляют статистические зависимости. Они показывают, какие признаки часто встречаются вместе, но не объясняют биологический механизм. Интерпретация и проверка гипотез остаются задачей специалиста.
Итог
ИИ в селекции каннабиса — это инструмент анализа больших объемов информации, а не самостоятельный селекционер. Он объединяет данные о генетике, химическом составе и условиях выращивания в единую систему оценки, где каждый параметр рассматривается в контексте других.
При достаточном количестве качественных и стандартизированных данных такие модели помогают быстрее отбирать перспективные линии, точнее прогнозировать химический профиль и более осознанно планировать гибридизацию. Селекция становится более структурированной и опирается на количественный анализ. При этом ключевые решения по-прежнему принимает специалист, который оценивает результаты с учетом практического опыта и понимания биологических процессов.
Источники:
- Çay, T. (2024). Prediction of THC levels in Cannabis species using machine learning methods. Bozok Journal of Agriculture and Natural Sciences, 3(2), 125–136.
- Najafabadi, M. Y. (2025). Machine learning-enhanced multi-trait genomic prediction for optimizing cannabinoid profiles in Cannabis sativa. The Plant Journal.
- Houston, A. (2025, December 10). Marijuana breeders can use AI to design new strains, study demonstrates. Marijuana Moment.


Будьте первым!